Capitulo 15
Correlación, asociación y multicolinealidad
Mide relaciones con el método correcto y evita convertirlas en explicaciones causales
Compara Pearson, Spearman y asociaciones categóricas; interpreta relaciones no lineales, confusores y multicolinealidad; usa VIF como diagnóstico y conserva la distinción entre asociación y causalidad.
Dos variables pueden moverse juntas porque una causa a la otra, porque comparten una causa, por selección o por azar. Una correlación descriptiva no distingue estas explicaciones ni demuestra causalidad.
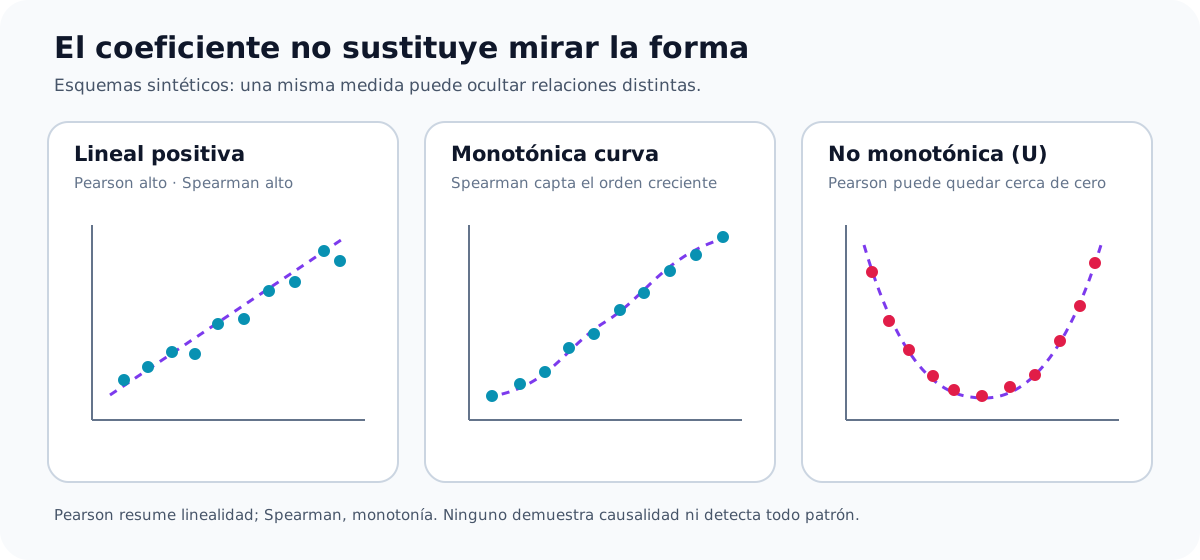
Primero dibuja la relación; después calcula el coeficiente y explica qué patrón captura.
— Principio de correlación
15.1 Asociación entre variables
Una medida de asociación resume dependencia entre variables. La elección depende del tipo de datos, forma de la relación y pregunta. Ningún coeficiente resume por sí solo todo el patrón.
Este capítulo corresponde al Módulo 16 del PDF: Teoría de correlación y asociación.
| Medida | Tipo / relación | Rango | Cuidado principal |
|---|---|---|---|
Pearson r | Dos variables numéricas; asociación lineal | −1 a 1 | Sensible a extremos y no detecta bien relaciones no lineales |
Spearman ρ | Rangos; asociación monotónica | −1 a 1 | Una relación no monotónica puede producir valor bajo aunque haya patrón fuerte |
Kendall τ | Rangos y orden | −1 a 1 | Interpretación por pares concordantes; puede ser más conservadora |
| Cramér’s V | Dos variables categóricas | 0 a 1 | Depende del tamaño de tabla; no tiene dirección |
| Point-biserial | Binaria y numérica | −1 a 1 | Es una forma de Pearson con un grupo codificado 0/1 |
import seaborn as sns
import matplotlib.pyplot as plt
from scipy.stats import pearsonr, spearmanr

sns.scatterplot(data=df, x="tenure", y="monthly_charges", hue="churn", alpha=0.5)
plt.show()

valid = df[["tenure", "monthly_charges"]].dropna()
print("Pearson:", pearsonr(valid["tenure"], valid["monthly_charges"]))
print("Spearman:", spearmanr(valid["tenure"], valid["monthly_charges"]))
El gráfico ayuda a detectar curvatura, grupos, heterocedasticidad y puntos dominantes. Reporta también cuántas filas se usaron y qué regla trató los faltantes. Un coeficiente de cero puede ocultar una relación en forma de U.
Asociación categórica
Para dos categorías, por ejemplo contrato y tipo de internet, una tabla de contingencia muestra conteos por combinación. Cramér’s V resume la intensidad de asociación, no su dirección ni causa.
import pandas as pd
from scipy.stats import chi2_contingency, contingency

table = pd.crosstab(df["contract"], df["internet_service"])
chi2 = chi2_contingency(table)
v = contingency.association(table, method="cramer")
print(table)
print("chi-square:", chi2.statistic, "p:", chi2.pvalue, "Cramer's V:", v)
Comprueba frecuencias esperadas para decidir si el contraste chi-cuadrado es apropiado; con celdas escasas, agrupa categorías solo si tiene sentido de dominio o usa una alternativa adecuada. El tamaño de efecto V complementa el p-valor.
15.2 Correlación no es causalidad
Un confusor es una variable que se relaciona con la exposición y el resultado y puede producir o distorsionar la asociación observada. En churn, contrato y cancelación pueden asociarse también con antigüedad, descuentos, tipo de servicio y canal de adquisición.
El siguiente dibujo muestra una posibilidad, no una conclusión:
antigüedad ──► tipo de contrato
     │                │
     └──────────────► churn
Para sostener una afirmación causal, el diseño debe considerar temporalidad, asignación de la intervención, confusores y supuestos del método (experimento aleatorio, diseño cuasi-experimental u otro). «Ajustar por todo» no es suficiente: condicionar en una variable posterior o en un collider también puede introducir sesgo.
15.3 Multicolinealidad: predictores que comparten información
En regresión, multicolinealidad aparece cuando una variable predictora puede aproximarse por combinación de otras. El modelo puede predecir razonablemente, pero los coeficientes individuales se vuelven inestables: signos y magnitudes cambian con pequeñas variaciones de muestra, y los errores estándar crecen.
- Correlación par a par: diagnóstico inicial; puede no detectar relaciones entre tres o más variables.
- VIF (Variance Inflation Factor): mide cuánto se infla la varianza estimada de un coeficiente por predictores relacionados. No es una prueba automática de eliminar columnas.
- Regularización: Ridge suele estabilizar coeficientes correlacionados; Lasso puede seleccionar, pero entre features muy similares la selección puede ser inestable.
- Decisión de dominio: variables redundantes pueden ser necesarias para cobertura, control o interpretación; revisa el objetivo antes de quitarlas.
import pandas as pd
from statsmodels.stats.outliers_influence import variance_inflation_factor
from statsmodels.tools.tools import add_constant

features = train_df[["tenure", "monthly_charges", "total_charges"]].dropna()
design = add_constant(features)
vif = pd.DataFrame({
    "feature": design.columns,
    "vif": [variance_inflation_factor(design.to_numpy(), i)
            for i in range(design.shape[1])],
})
print(vif)
train_df debe ser solo el conjunto de entrenamiento si el diagnóstico guía selección de variables para el modelo. VIF no es comparable como regla universal entre todos los diseños; úsalo junto con estabilidad, propósito predictivo, escala, codificación y conocimiento del dominio.
15.4 Interpretar una matriz de correlación con cuidado
import matplotlib.pyplot as plt
import seaborn as sns

numeric = train_df.select_dtypes(include="number")
corr = numeric.corr(method="spearman", min_periods=30)
sns.heatmap(corr, cmap="vlag", center=0, vmin=-1, vmax=1, annot=True, fmt=".2f")
plt.title("Asociación monotónica en train")
plt.tight_layout()
plt.show()
El mapa ayuda a priorizar preguntas, no a seleccionar variables automáticamente. Revisa:
- ¿La relación es lineal o monotónica?
- ¿Hay grupos que mezclados crean una asociación aparente?
- ¿Los extremos dominan el coeficiente?
- ¿Las columnas derivadas comparten una definición (por ejemplo, cargo mensual y total acumulado)?
- ¿Se usaron las mismas filas para cada par o la matriz tiene distintos niveles de faltantes?
- ¿La selección se calculó solo con train cuando se usa para construir un modelo?
Multicolinealidad
M15Dependencia aproximadamente lineal entre dos o más variables predictoras que dificulta separar sus efectos en un modelo de regresión.
Ej: `monthly_charges`, `tenure` y `total_charges` pueden compartir información porque el total está relacionado con cargo y antigüedad; los coeficientes individuales pueden variar al cambiar la muestra.
Con el dataset de churn, elige cuatro variables numéricas. Grafica relaciones, calcula Pearson y Spearman, y explica cualquier diferencia. Calcula VIF en train; compara coeficientes de una regresión logística sin regularizar y con Ridge en varios folds. Reporta qué cambia, qué predice mejor y por qué ninguna de esas observaciones demuestra causalidad.
💡 Se relaciona con la varianza de un coeficiente estimado.
Q: ¿Cómo distinguirías una asociación de una conclusión causal?
Una asociación describe variación conjunta en los datos. Para una afirmación causal necesito un diseño y supuestos que identifiquen qué habría ocurrido bajo otra intervención, considerar temporalidad y confusión y reportar incertidumbre.
🪤 Afirmar que controlar varias columnas convierte automáticamente un estudio observacional en experimento.Para continuar
El análisis exploratorio y las decisiones estadísticas alimentan un proyecto completo, pero no sustituyen una secuencia reproducible. M16 integra definición, adquisición, calidad, modelado, comunicación y validación en un solo entregable.
Tu espacio de estudio
Notas privadas
Se guardan solo en este navegador y no se publican.